UTM Backup Manager
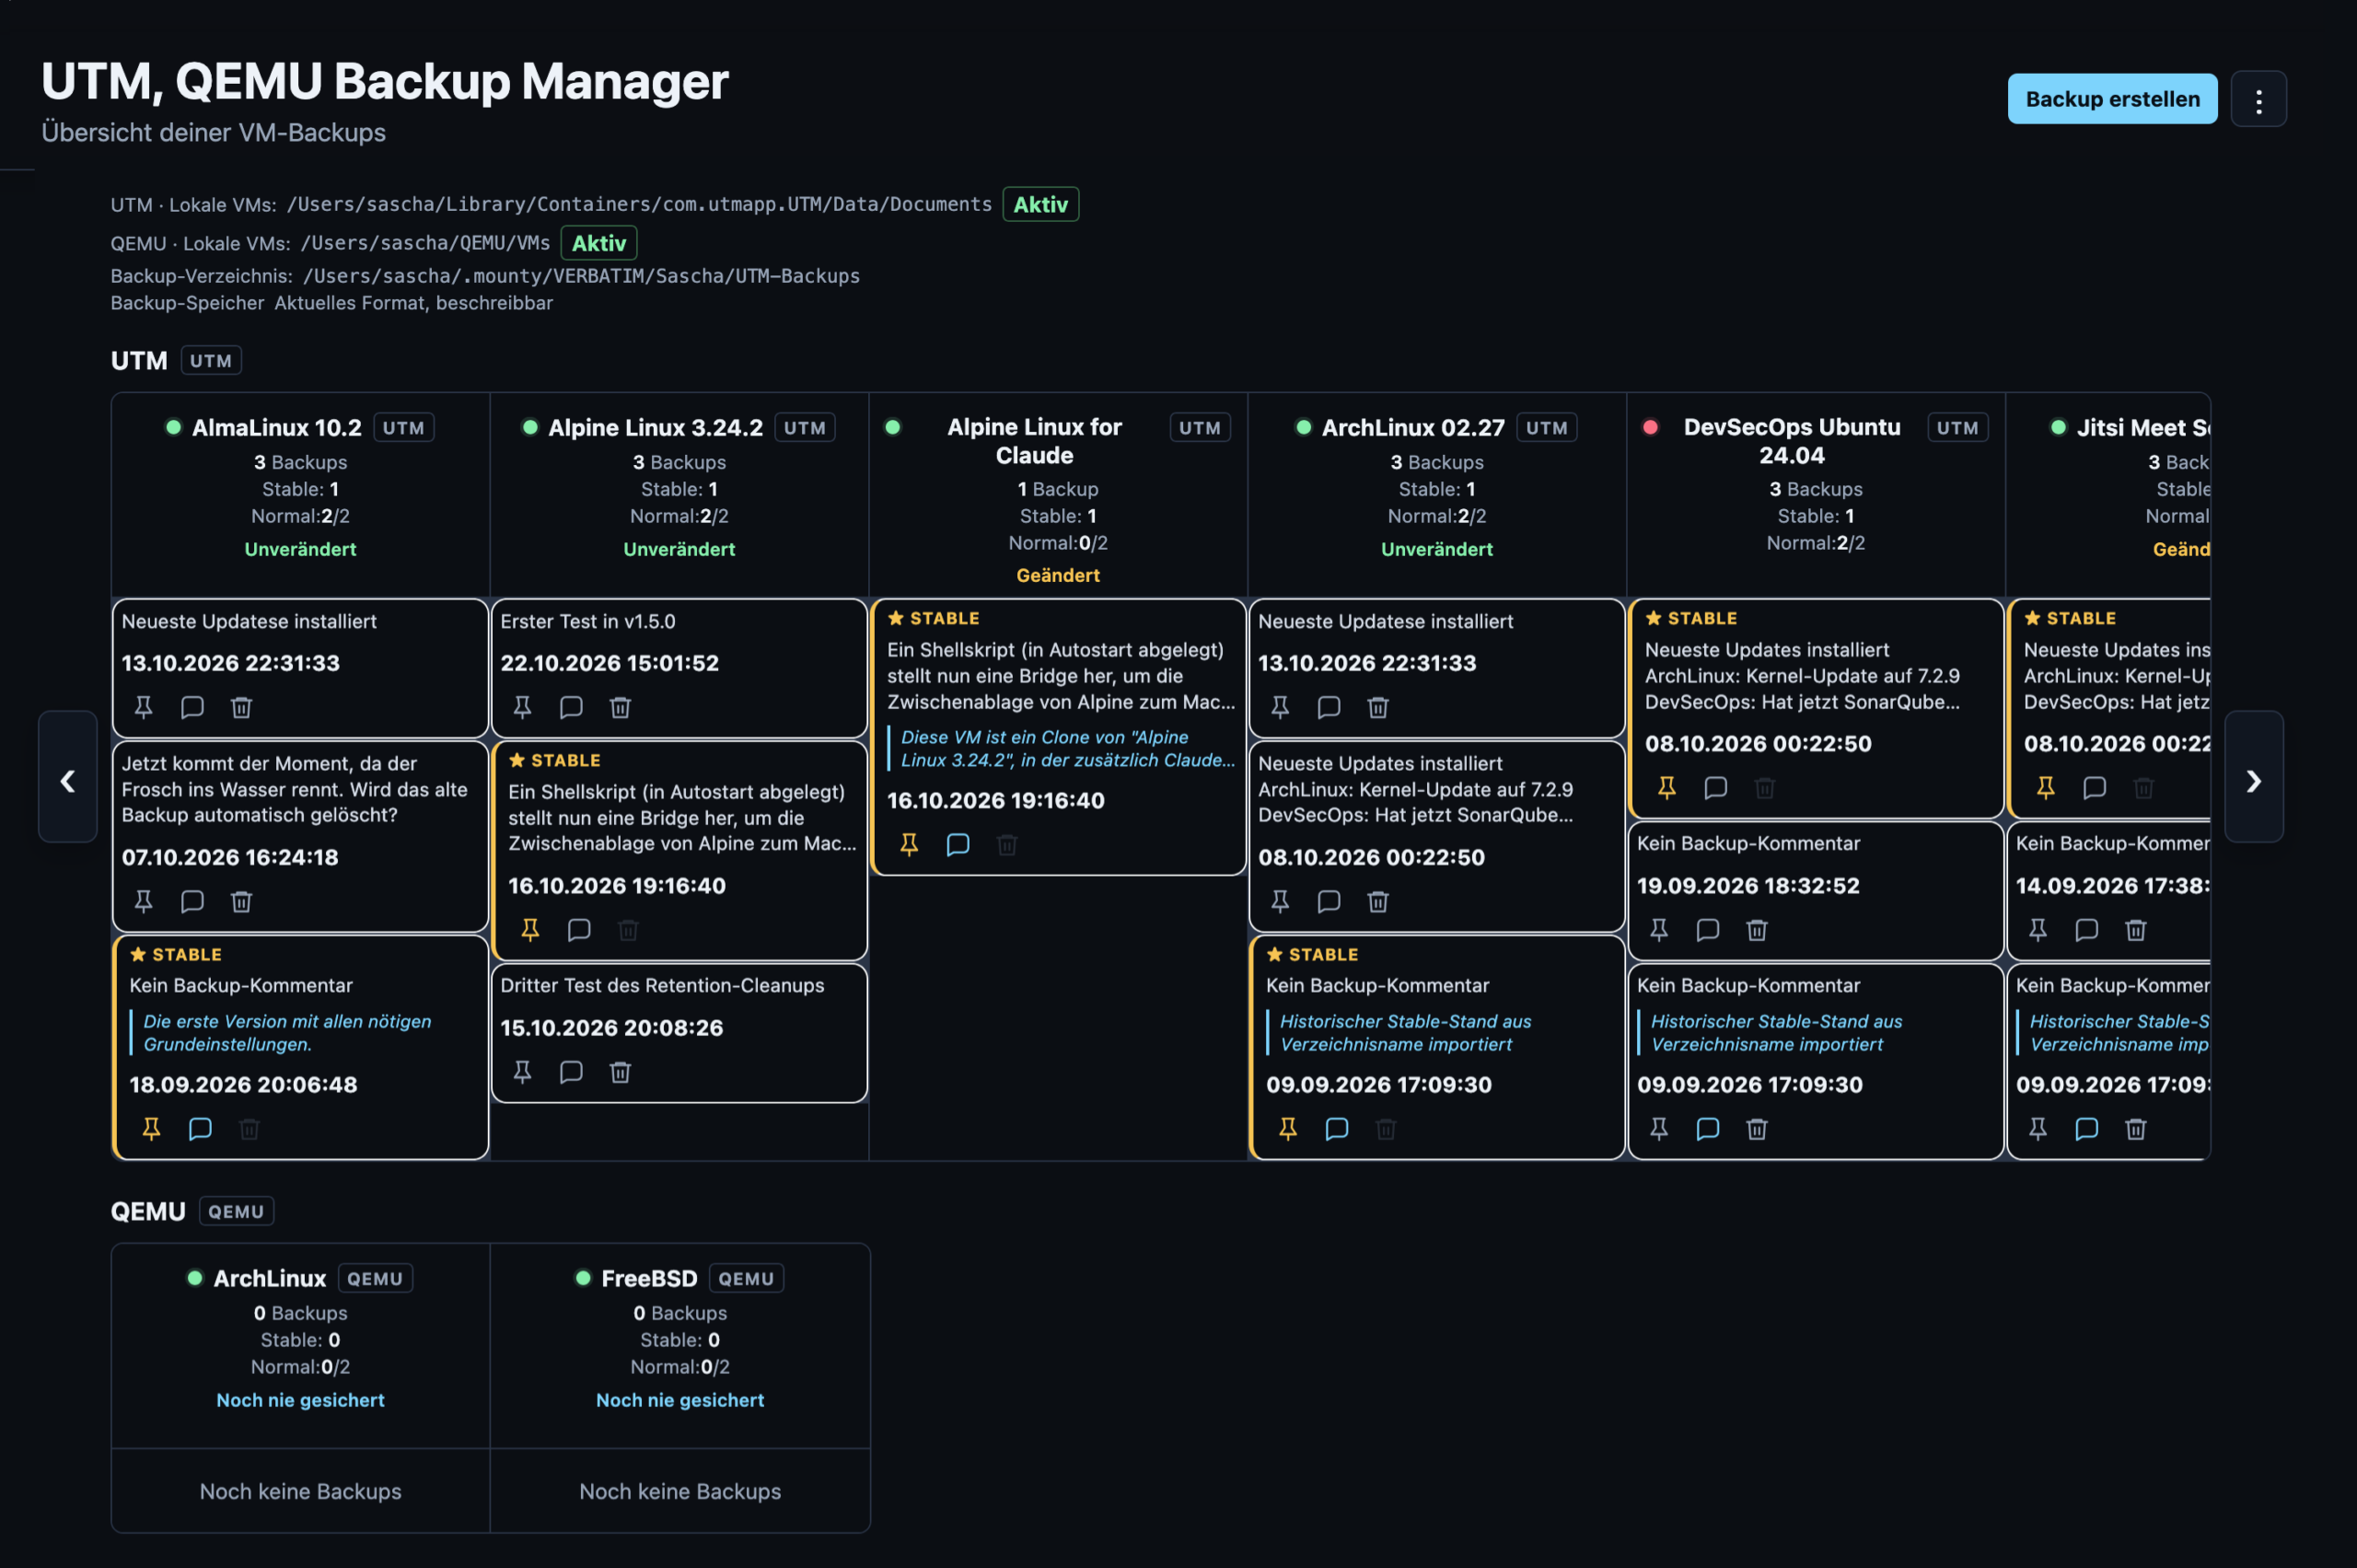
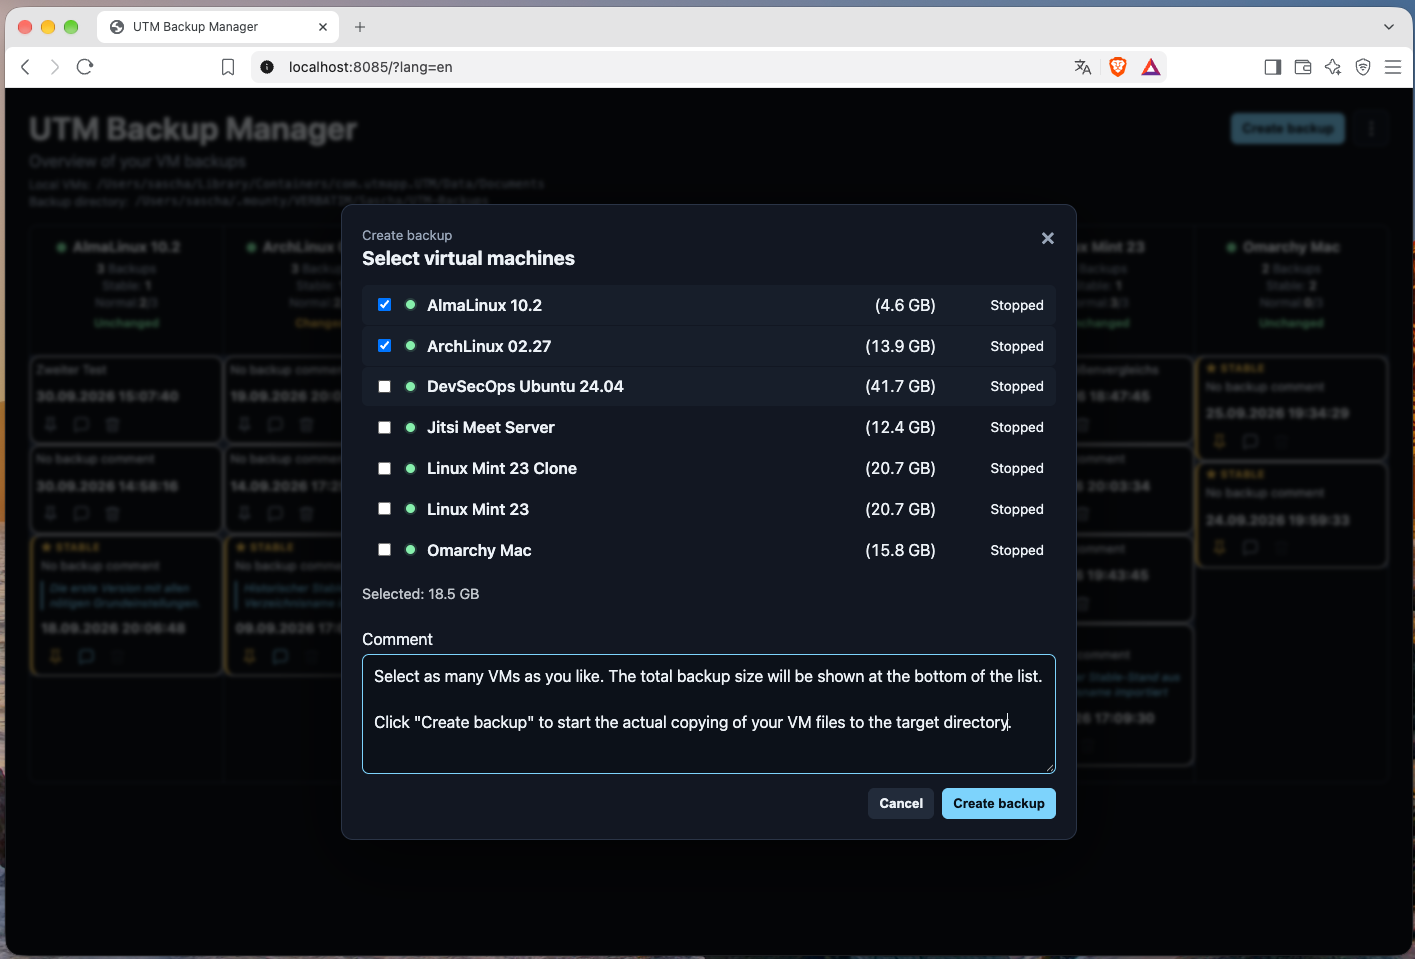
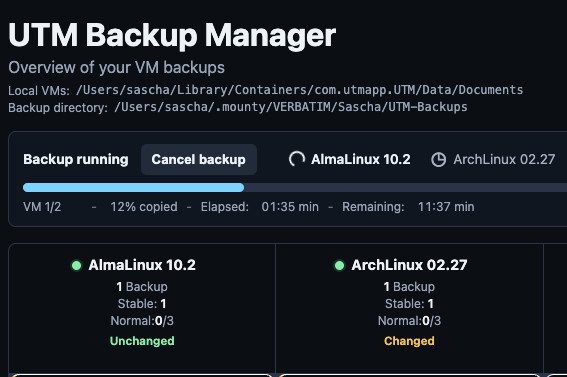
In meinem Linux-Lab wuchs die Zahl der VMs und damit der Zustände, die ich als Backup sichern wollte. Anfangs tat es ein komfortables Shellskript, das mir die Auswahl der zu sichernden VMs bot und den Kopiervorgang mit rsync startete, inklusive automatischer Kommentare und Speicherung einer Liste der Backups in einer Textdatei. Aber: Mit der Zeit verlor ich den Überblick. Welche Sicherungsstände gibt es für welche VM – und welche davon möchte ich dauerhaft behalten? Darum habe ich eine Webanwendung mit Java und Spring Boot entwickelt.
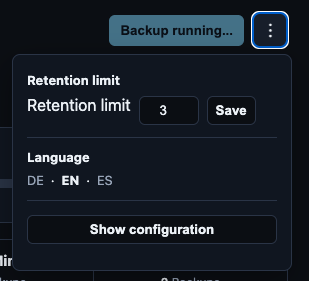
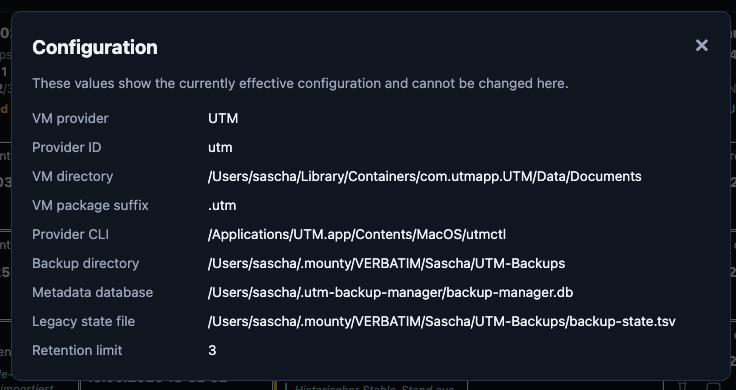
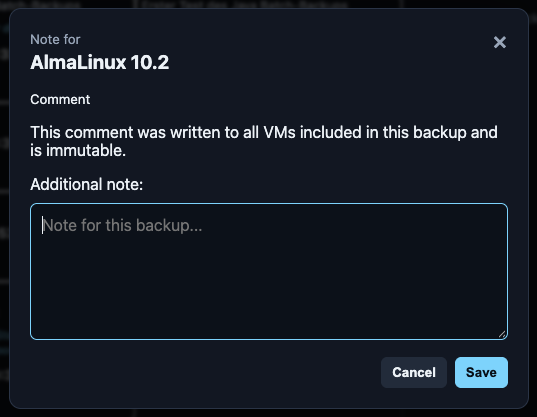
Die Anwendung liest vorhandene Backup-Verzeichnisse ein und stellt die Sicherungen nach VM und Datum dar. Kommentare und Stable-Markierungen werden in SQLite verwaltet. Als stabil markierte Backups sind vor dem Löschen über die Anwendung geschützt.
Eine konkrete Herausforderung
Für einen zuverlässigen CI-Lauf musste die Testkonfiguration zum Session-Verhalten der Anwendung passen. Nach der Anpassung der Test-Properties lief der Build erfolgreich durch. Damit werden Änderungen nicht nur lokal geprüft, sondern auch im GitHub-Workflow.
Technologien: IntelliJ Community Edition · Java 21 · Spring Boot · Maven · SQLite · HTML/CSS · Git · GitHub Actions · SonarQube · UTM/ utmctl
Status: Im eigenen Einsatz und aktiv weiterentwickelt. Die Liste der Feature-Ideen ist noch lang. 😊
Entwicklung mit Claude Code
Mit Version 1.5.0 habe ich das Projekt außerdem genutzt, um den praktischen Einsatz eines KI-gestützten Coding Agents kennenzulernen. Dafür habe ich Claude Code bewusst nicht auf meinem Entwicklungsrechner, sondern in meiner bereits vorhandenen DevSecOps-Ubuntu-VM eingerichtet.
Die Erweiterung des Backup Managers um eine Multi-Provider-Architektur und QEMU als zweiten Hypervisor habe ich gemeinsam mit Claude Code in zehn aufeinander aufbauende Entwicklungsphasen zerlegt. Architektur und Anforderungen habe ich dabei selbst vorgegeben und die einzelnen Aufgaben bewusst eng abgegrenzt. Claude Code übernahm anschließend Teile der Implementierung und der Tests.
Besonders wichtig war mir, die Arbeit des Coding Agents nicht ungeprüft zu übernehmen. Jede Phase wurde durch automatisierte Tests abgesichert, größere Zwischenschritte zusätzlich mit SonarQube analysiert und das Verhalten anschließend praktisch getestet. Commit, Merge und Release blieben ebenfalls bewusst außerhalb der automatisierten Claude-Code-Arbeit.
Dabei habe ich vor allem gelernt, dass der sinnvolle Einsatz eines Coding Agents weniger darin besteht, möglichst große Aufgaben auf einmal an eine KI zu delegieren. Gute Ergebnisse entstanden vielmehr durch klar formulierte Anforderungen, kleine überprüfbare Schritte, explizite Grenzen und ein vorhandenes technisches Sicherheitsnetz aus Tests und statischer Codeanalyse.
Ein anschauliches Beispiel war die QEMU-Integration: Obwohl die Implementierung zunächst alle Tests bestand, zeigte ein Test auf macOS einen sicherheitsrelevanten Sonderfall bei der Auflösung symbolischer Links in Verzeichnisnamen. Erst nach der Analyse und einem zusätzlichen Regressionstest wurde die Erkennung zur Laufzeit entsprechend korrigiert. Für mich war das eine gute praktische Erfahrung darin, KI-Unterstützung mit klassischer Software-Qualitätssicherung zu verbinden.